ETL/ELT
Automated ETL Pipeline
Batch processing framework with data quality checks & monitoring
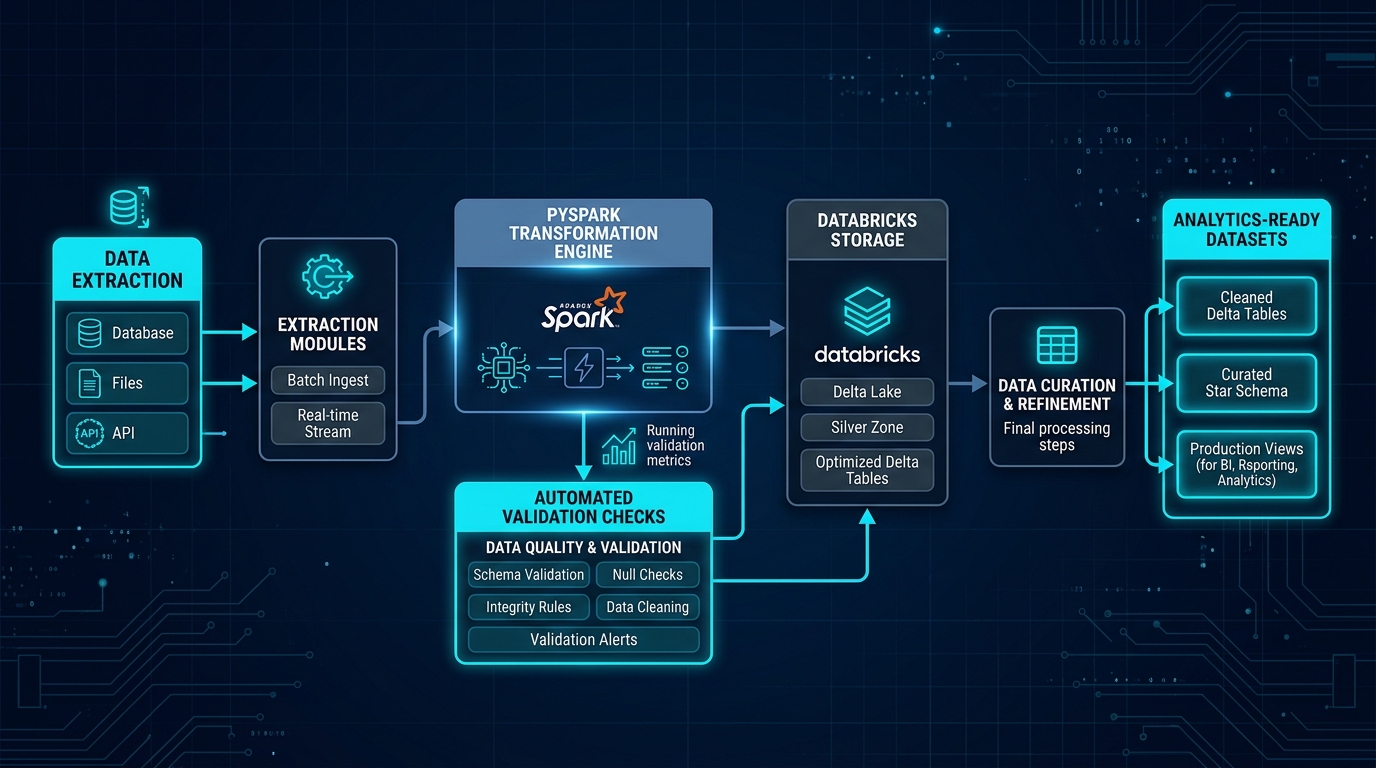
Project Overview
Developed a Python and PySpark-driven ETL framework designed for automated batch data processing. The system orchestrates extraction from source systems, applies business transformations, runs quality assertions before loading, and maintains operational logs for failure monitoring and automated retry execution.
The Problem
Manual batch data jobs were prone to silent failures, missing validation checks, and lack of alerting.
The Solution & Architecture
Created an automated modular ETL pipeline on Databricks with explicit data quality assertions, batch scheduling, and retry mechanisms.
System Data Flow:
Source Databases / Files→Extraction Module→Validation & Transformation→Target Storage / Databricks→Monitoring & Alerts
Key Engineering Highlights
Automated extraction from diverse data sources
Scalable PySpark transformation engine
Data quality checks and validation rules
Reliable automated loading routines
Distributed batch processing capabilities
Pipeline monitoring and error logging
Technologies Used
PythonSQLPySparkDatabricks
Interested in this Pipeline?
I can build similar production-grade Lakehouse or API data ingestion systems for your organization.
Contact Owais Ahmad